TypeSafe AI 在 9 月 15 日发布了 Jev,官方称它是第一个 System One 模型。它不写句子,你把一段状态和几组问题丢进去,它返回带概率的类型化答案,代码直接拿去做判断。名字取自经济学家威廉·斯坦利·杰文斯,官方的说法是智能成本每降一个数量级,用它的场景就会多一个数量级。
如果拿人体打比方:LLM 是大脑,负责想清楚再开口;Jev 更像脊髓里的反射弧,输入进来立刻给出动作,不写作文,也不解释自己为什么这么判。这个比喻哪里贴切、哪里会误导,放在后面说。
它不是小号 LLM
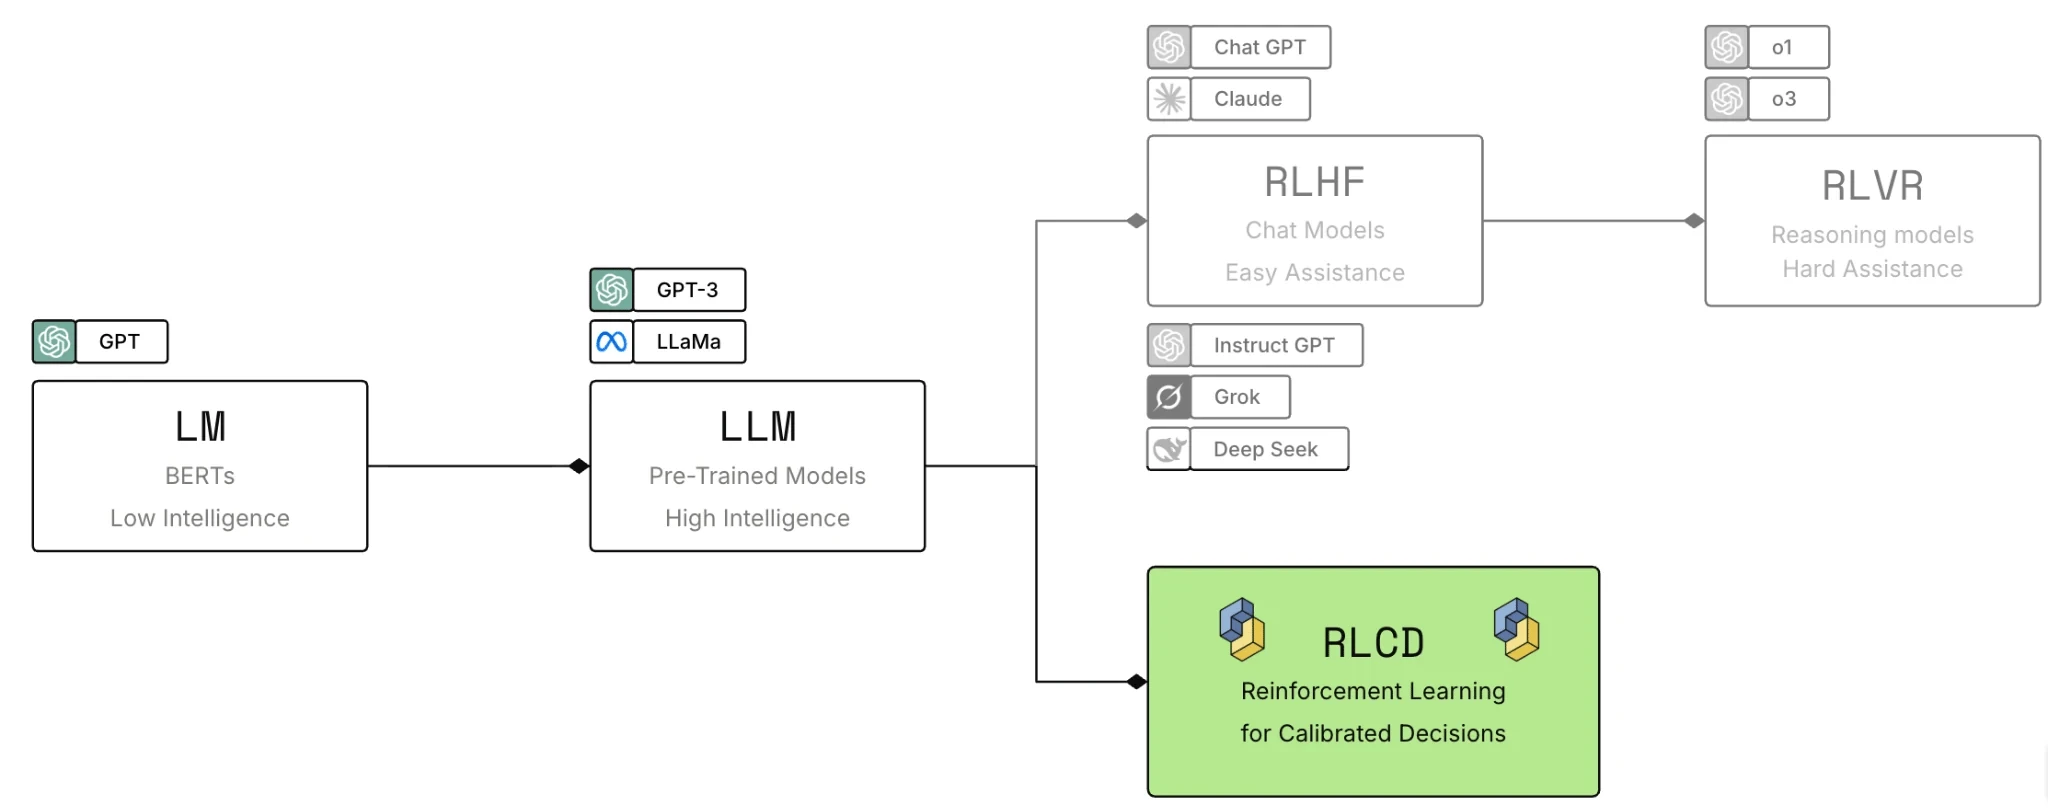
这两年模型的训练路线主要有两条。RLHF 让模型学会说人爱听的话,于是有了聊天助手;RLVR 用可验证的奖励训推理,数学和代码变强,也更慢更贵。TypeSafe 想做的是第三条,他们叫 RLCD,Reinforcement Learning for Calibrated Decisions,把概率对准真实结果,而不是对准人的偏好。
输出合同因此完全不同。LLM 生成字符串,你要解析、校验,还要防它偶尔编出不存在的字段;Jev 的答案空间是你提前定义好的,只在里面挑,所以官方敢写类型错误按构造是 0%。注意这只解决格式问题,不解决对错问题。
一次调用,状态进,决定出
接口只有一个 POST /v1/systemone,请求里放 state 和 questions,默认模型是 jev-latest,当前文档对应 1.13 版。问题只有三种:Choice 从选项里挑一个,最多 255 个;Score 落在你用文字描述的 2 到 10 级量表上,可以停在级别之间,比如 1.4;Noul 回答一个是非题,返回 0 到 1 的概率。
三种问题可以混在同一次请求里。它们并行且彼此隔离,多问几个几乎不增加响应时间,也不会因为话题变多互相干扰。下面是官方文档里的请求,一次问清工单归哪个团队、客户有多不满、消息急不急:
{
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated the customer appears",
      "criteria": [
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language"
      ]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
返回的就是决定和概率,没有一段需要解析的自然语言。下面是同一份文档里的响应节选,省掉了每个级别的说明文字:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "confidence": 0.78,
      "probabilities": { "technical": 0.85, "sales": 0.0, "billing": 0.15 }
    },
    "frustration": { "type": "score", "score": 1.0, "confidence": 1.0 },
    "is_urgent": { "type": "noul", "noul": 1.0 }
  }
}
Choice 和 Score 都带 confidence,你的代码用它决定自动执行还是转人工;Noul 只有一个是非概率,本身就是完整描述。官方文档把这种用法叫“智能 if 语句”,手写规则太脆的地方,就用它做分类、路由、打分、抽取和分支。
大脑、反射弧、肌肉
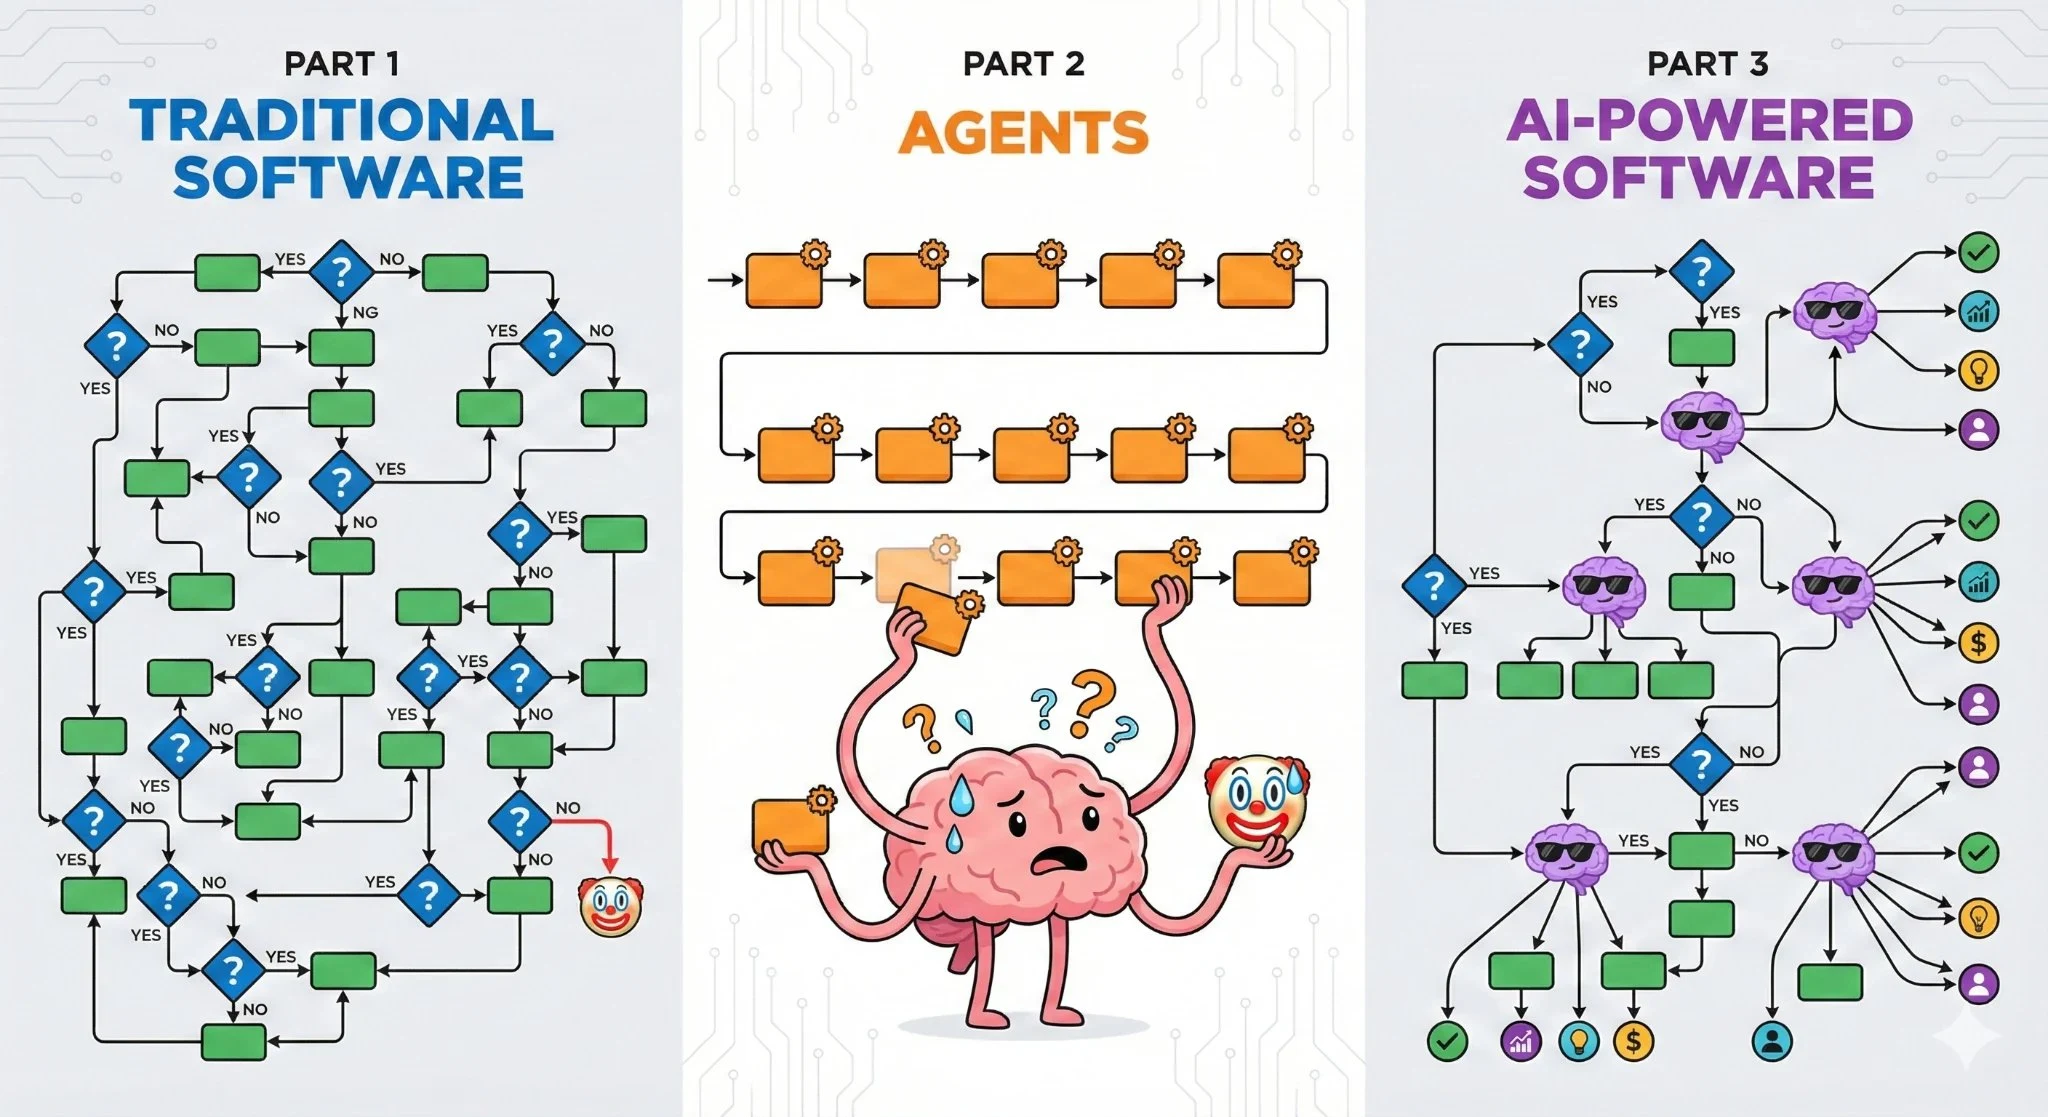
LLM 像大脑皮层:能推理、能写、能解释,但每次都要从头想一遍,慢且贵,还偶尔一本正经地胡说。Jev 像脊髓反射弧:感觉信号进去,动作指令出来,中间没有语言这一层。敲膝盖不会顺便给你写一段理由,Jev 也不解释,它压根不生成文本,自然也就不存在“编一段听起来合理的说明”。
真正动手的仍然是普通代码,相当于肌肉和骨头。反射弧只发信号:这条工单归技术、这条评论要下架、这句话踩线了。判断和执行分开,是这套设计里最关键的一步。
比喻到这里就不再准确了。人的反射是硬连线的,一个刺激对一个反应;Jev 是训练出来的,处理的是没写死的语义判断,所以它能应付没见过的输入。代价同样直接:反射不会错,模型会。官方也写明校准是群体属性,在一堆预测上概率对得上,不代表这一次必然正确。
它做不了什么
不写文案、不生成代码、不解释推理过程,这三件事直接不在能力范围内。它也没有世界知识,只认你放进 state 的内容,不会自己查任何东西,所以喂进去的状态决定了能力上限。目前只接受文本,字符串、JSON 对象和文本数组都行,图像、音频、视频都不支持,单次请求的上下文上限是 64k token。
中文要自己测。官方文档写明英文是主要训练语言、表现最好,CJK 能用但不如英文稳,建议拿自己的内容验证过再上。
什么时候值得接进来
适合的是高频、重复、答案集已知的判断:工单分类、意图路由、内容审核、信息抽取、打分,以及给其他模型的输出做护栏。常见的接法是三级:Jev 用很低的成本完成分类和路由,确定性代码处理能处理的部分,剩下的少数复杂情况才交给前沿模型或者人。省下的是昂贵的模型调用,换来的是“哪些事机器定、哪些事必须人来”这条清楚的边界。
现在还是早期访问。输入每百万 token 0.042 美元、输出免费、70 到 500 毫秒,这些数字都是官方自测:评测跑在他们自己的笔记本上,基准用 GPT-6 Astra 和 Fable 5.1 的平均值当参考答案,定价能不能长期维持,官方自己也说证明不了。要不要用,最靠谱的判断方式还是挑一个你自己的高频判断场景,拿同一批数据跟现有方案跑一遍。